gpt-oss-20b
Dans cet article
Information
gpt-oss-20b est un modèle open-weight de taille moyenne d'OpenAI, conçu pour un fonctionnement efficace avec une faible latence dans les déploiements locaux ou les cas d'utilisation spécialisés. Le modèle possède 20 milliards de paramètres, dont 3,6 milliards actifs, ce qui lui permet de s'exécuter sur du matériel aux ressources limitées, tel que des appareils disposant de 16 Go de mémoire. Il peut être déployé localement, y compris sur du matériel grand public.
Fonctionnalités principales de gpt-oss-20b
- Architecture optimisée : Le modèle gpt-oss-20b possède 20 milliards de paramètres au total et n'active que 3,6 milliards, assurant des performances élevées tout en utilisant efficacement les ressources.
- Capacités agent étendues : Le modèle intègre des fonctionnalités natives pour l'appel de fonctions, la consultation de pages web, l'exécution de code Python et la génération de sorties structurées. Il excelle dans la résolution de tâches et l'appel d'outils.
- Raisonnement avec niveaux d'intensité ajustables : Fonctionnellement, le modèle est un résolveur de tâches fiable prenant en charge des méthodes telles que le raisonnement en chaîne de pensée (chain-of-thought). Il offre trois niveaux d'intensité de raisonnement personnalisables.
- Performances et compatibilité : Le modèle gpt-oss-20b affiche des résultats comparables à ceux d'OpenAI o3-mini sur les benchmarks courants. Grâce à l'optimisation, il peut fonctionner sur des appareils edge disposant de 16 Go de mémoire.
- Support multilingue : Le modèle dispose de fonctionnalités multilingues. Pour des résultats optimaux, il est recommandé de spécifier explicitement la langue cible et le contexte culturel pour l'interaction.
- Quantification des données : La prise en charge du format MXFP4 assure un fonctionnement efficace du modèle sur du matériel aux ressources limitées, améliorant ainsi les performances globales du système.
Fonctionnalités de déploiement
| ID | OS compatible | VM | BM | VGPU | GPU | CPU min (Cœurs) | RAM min (Go) | HDD/SSD min (Go) | Actif |
|---|---|---|---|---|---|---|---|---|---|
| 345 | Ubuntu 22.04 GPU | - | - | + | + | 8 | 60 | 15 | ORDER |
Spécifications techniques de la configuration :
- Ubuntu 22.04 avec noyau mis à jour vers la version 6 ;
- Derniers pilotes Nvidia ;
- CUDA Toolkit ;
- Ollama pour la gestion des modèles ;
- OpenWebUI pour l'interface web.
Caractéristiques d'installation :
- Le temps d'installation est de 25 à 45 minutes, configuration du système d'exploitation incluse ;
- Le serveur Ollama charge et exécute le modèle gpt-oss-20b en mémoire GPU/RAM ;
- Open WebUI est déployé en tant qu'application web connectée au serveur Ollama ;
- Les utilisateurs interagissent avec le modèle via l'interface web Open WebUI pour les tâches de programmation et d'agent ;
- Tous les calculs et le traitement du code se produisent localement sur le serveur ;
- Les administrateurs peuvent configurer le modèle pour des tâches de développement spécifiques à l'aide des outils OpenWebUI ;
- Prise en charge de divers niveaux de quantification pour optimiser l'utilisation de la mémoire.
Prise en main après le déploiement de gpt-oss-20b
Après le paiement, une notification concernant la disponibilité du serveur sera envoyée à l'adresse e-mail enregistrée lors de la commande. Elle contiendra l'adresse IP du VPS, l'identifiant et le mot de passe pour l'accès au serveur, ainsi qu'un lien vers le panneau de contrôle OpenWebUI. Les clients gèrent l'équipement via le Panneau de gestion des serveurs et l'API — Invapi.
- Identifiants pour l'accès au serveur OS (par exemple, via SSH) seront envoyés dans l'e-mail reçu.
- Lien vers le panneau de contrôle Ollama avec l'interface web Open WebUI : dans la balise webpanel de l'onglet Configuration >> Tags du panneau de contrôle d'Invapi. Le lien exact, par exemple
https://gpt-oss<Server_ID_from_Invapi>.hostkey.in, est fourni dans l'e-mail envoyé lors de la livraison du serveur.
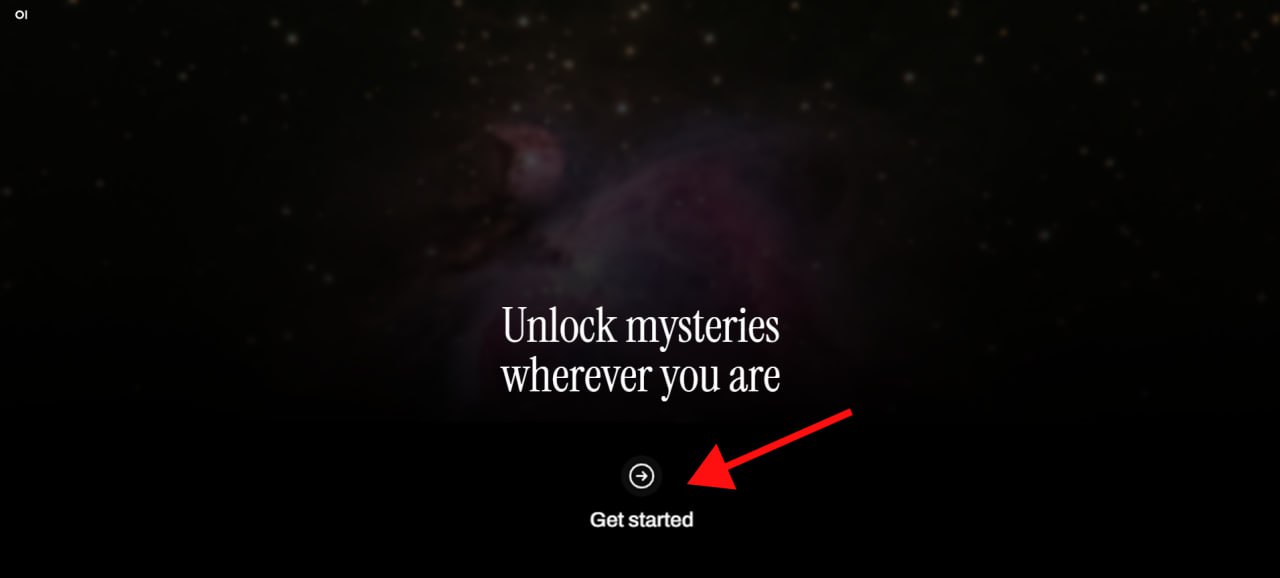
Lors de la première visite du lien de la balise webpanel, une page d'accueil s'ouvrira. Cliquez sur le bouton Get started pour commencer la configuration.
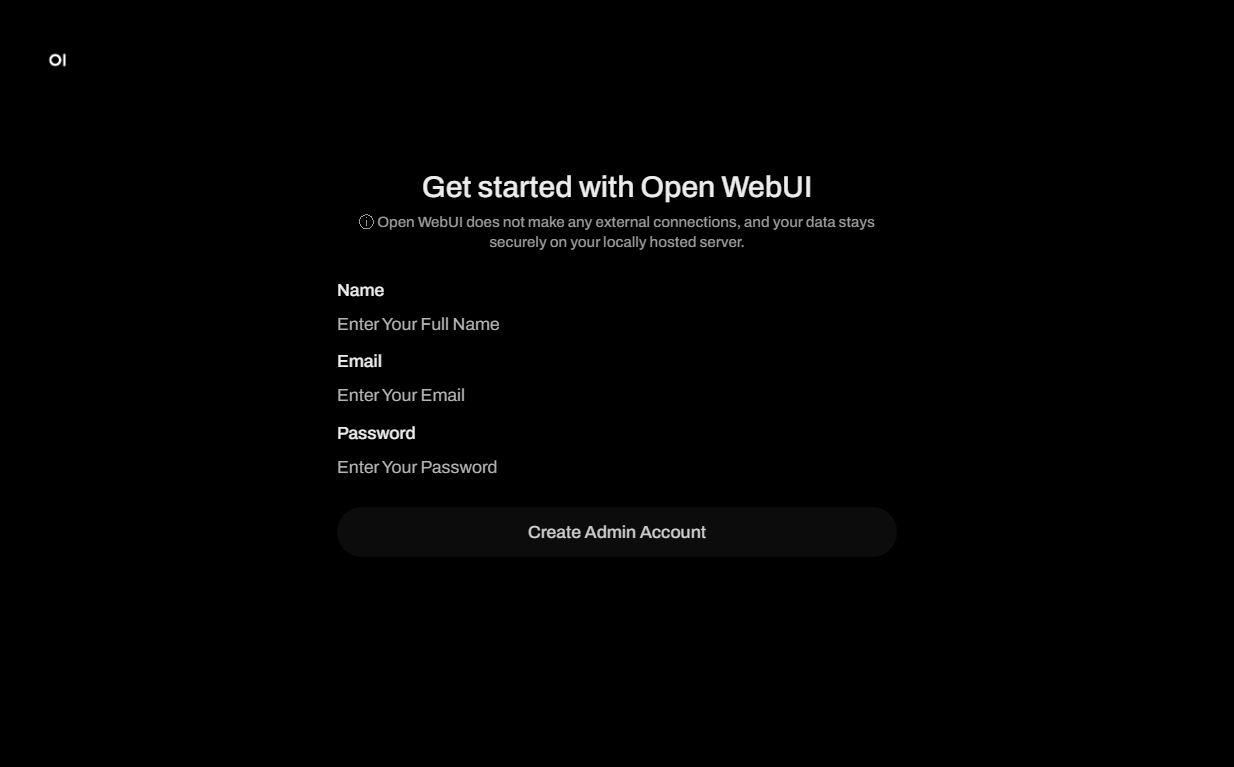
Après avoir cliqué sur le lien de la balise webpanel, une fenêtre de connexion Get started with Open WebUI s'ouvrira, où vous devrez créer un nom de compte administrateur, un e-mail et un mot de passe pour votre chatbot, puis appuyer sur le bouton Create Admin Account :
Attention
Après l'enregistrement du premier utilisateur, le système lui attribue automatiquement un rôle d'administrateur. Pour garantir la sécurité et le contrôle du processus d'enregistrement, toutes les demandes d'enregistrement ultérieures doivent être approuvées dans OpenWebUI depuis le compte administrateur.
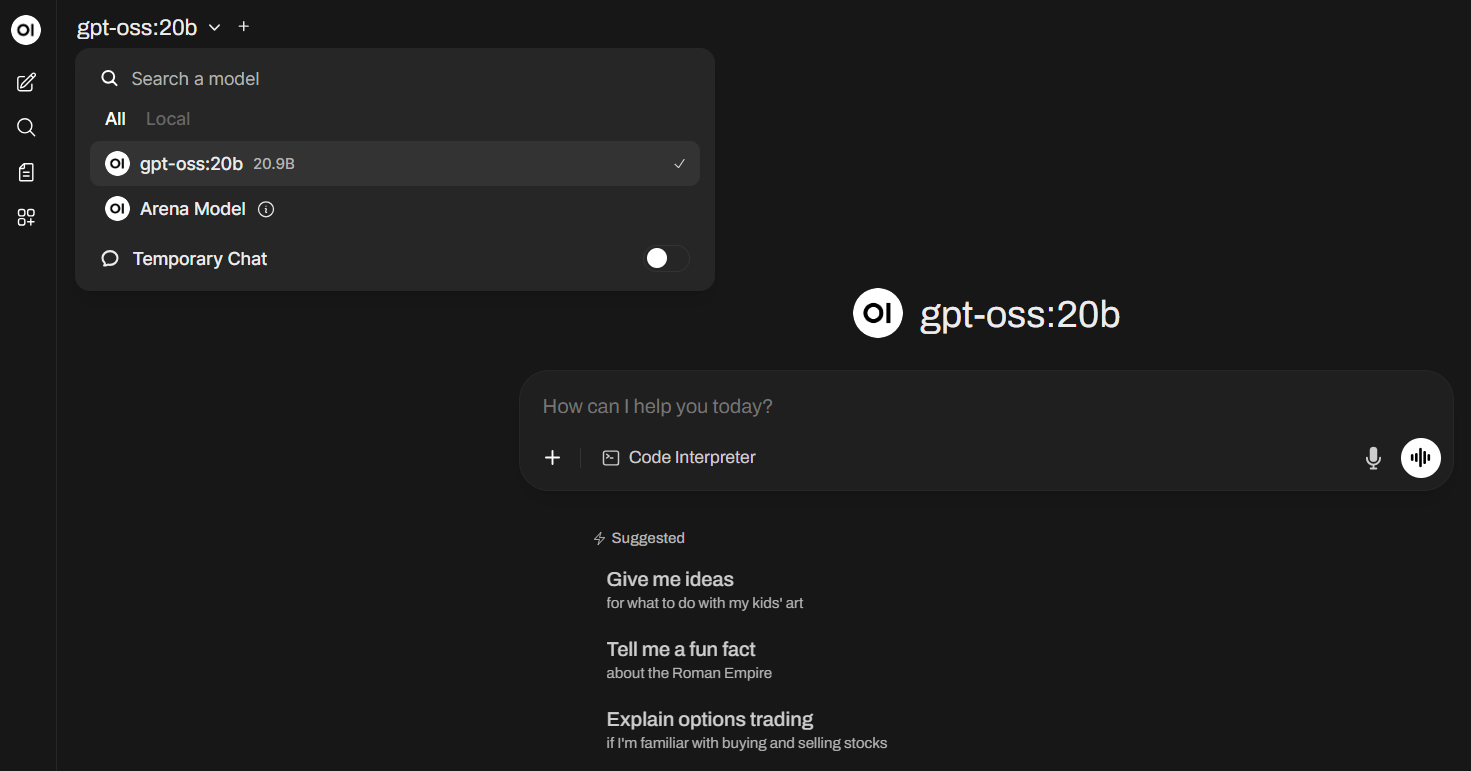
Après une inscription réussie, l'interface principale Open WebUI avec accès à Gpt-oss-20b s'ouvrira :
Remarque
Des informations détaillées sur l'utilisation du panneau de contrôle Ollama avec Open WebUI peuvent être trouvées dans l'article Chatbot IA sur votre propre serveur.
Remarque
Pour un fonctionnement optimal avec le modèle gpt-oss-20b, il est recommandé d'utiliser un GPU avec au moins 16 Go de mémoire vidéo pour le modèle 20B. Pour un traitement efficace de longs contextes de code et de tâches agent complexes, nous recommandons d'utiliser des GPU avec 24 Go de mémoire vidéo. Des informations détaillées sur les paramètres principaux d'Ollama et d'Open WebUI peuvent être trouvées dans la documentation développeur d'Ollama et dans la documentation développeur d'Open WebUI.
Recommandations d'utilisation
Pour maximiser l'efficacité du modèle gpt-oss 20B, il est recommandé de :
- Utiliser le modèle pour les tâches de raisonnement, y compris le traitement en chaîne de pensée. Le modèle prend en charge des niveaux de raisonnement ajustables : faible, moyen et élevé, qui sont configurés via un prompt système.
- Exploiter les capacités agent intégrées du modèle, telles que l'appel de fonctions, l'exécution de code Python et les sorties structurées.
- Employer le modèle pour des tâches de développement multi-étapes en tirant parti de ses capacités d'agent.
- Intégrer le modèle avec les outils de développement existants via l'API, en tenant compte du fait qu'il prend en charge l'ajustement (tuning) et fonctionne au format de réponse OpenAI Harmony. Le modèle est conçu pour un déploiement efficace avec une faible latence, y compris localement.
Commande d'un serveur avec gpt-oss-20b via l'API
Pour installer ce logiciel via l'API, suivez ces instructions.